¿Instalamos el modelo de lenguaje en nuestros propios equipos o pagamos por uso a un proveedor? La pregunta aparece en cuanto una empresa se plantea trabajar con inteligencia artificial generativa sobre sus propios datos. Y casi siempre se responde con intuiciones: que lo local es más lento, que la API acierta más, que el hardware no compensa.
Preferimos medirlo. Entre el 29 de octubre y el 2 de noviembre de 2026 sometimos a seis modelos de lenguaje de gran tamaño (LLM), tres ejecutados en local y tres consumidos por API, a 588 preguntas extraídas de tres benchmarks de referencia. Registramos precisión, tiempo de respuesta, coste y consumo eléctrico real.
La conclusión principal del ensayo LLM local vs API es esta: el mejor modelo local, DeepSeek V4.1 Flash sobre dos NVIDIA DGX Spark, no presenta diferencias estadísticamente significativas de precisión frente a los mejores modelos por API. La decisión, por tanto, no depende de qué modelo acierta más, sino de dónde deben procesarse los datos y de cuánto se va a usar.
Cómo diseñamos el ensayo
El estudio lo firman Leon Arnedo y David Max, de Encore Lab, junto a Ana González Marcos, de la Universidad de La Rioja.
Las preguntas proceden de tres benchmarks públicos que miden capacidades distintas:
- IFEval: capacidad de seguir instrucciones verificables de forma automática, como respetar una longitud, un formato o unas palabras clave.
- LongBench: comprensión y razonamiento sobre contextos largos.
- GPQA Diamond: preguntas de nivel de posgrado en biología, física y química, diseñadas para que no puedan resolverse con una búsqueda en internet. Diamond es su subconjunto más exigente.
El hardware: dos DGX Spark bajo carga sostenida
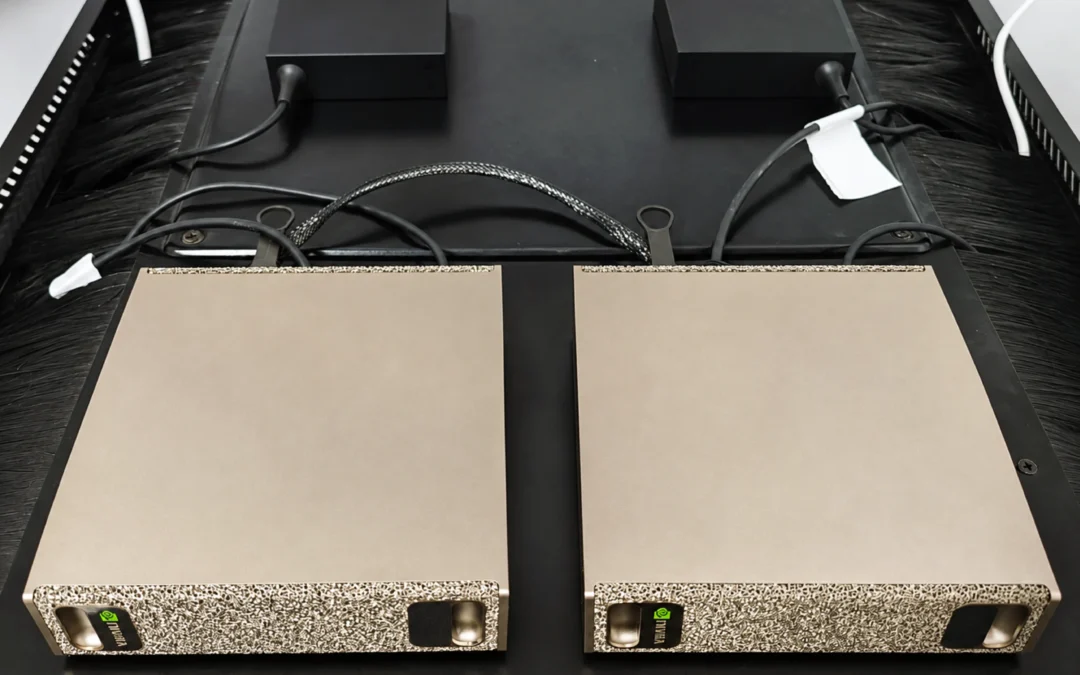
La parte local se ejecutó sobre dos NVIDIA DGX Spark. El conjunto sirve un único modelo cada vez.
Desde la ingeniería hay un dato que nos interesa tanto como la precisión: la estabilidad bajo carga. Durante esas casi nueve horas, el sistema no tuvo que limitar su rendimiento por temperatura ni por potencia. Un equipo que pierde prestaciones a la tercera hora de trabajo sirve para una demostración, no para producción.
Precisión: el modelo local juega en la misma liga
DeepSeek V4.1 Flash en local alcanzó un 95,3 % en IFEval y un 86,9 % en GPQA Diamond, con 26,8 segundos y 1,71 Wh netos por pregunta. Fue el modelo local más rápido del ensayo y el que menos energía neta consumió. Por API, Claude Opus 5.5 llegó al 90,9 % en GPQA Diamond y DeepSeek V4.1 Flash, al 96,7 % en IFEval.
Coste: aquí sí hay diferencias
| Opción y concepto | Coste |
|---|---|
| LOCAL2 DGX Spark Electricidad |
0,35 € por cada 1.000 preguntas |
| LOCAL2 DGX Spark Inversión en equipos |
10.742 € sin IVA |
| APIClaude Opus 5.5 Ejecución completa (588 preguntas) |
19,76 $ 3,36 centavos de dólar por pregunta |
| APIDeepSeek V4.1 Flash Ejecución completa (588 preguntas) |
2,56 $ 0,44 centavos de dólar por pregunta |
Con estas cifras, y en un escenario de uso continuo, la inversión en los dos equipos se amortiza así:
Son plazos orientativos: el real depende del volumen de consultas de cada empresa y de cuántas horas al día trabaje el sistema. La otra lectura es igual de clara: por API, Claude Opus 5.5 costó unas ocho veces más que DeepSeek V4.1 Flash sin ofrecer una precisión significativamente superior.
Energía medida, no estimada
Los datos de consumo del informe no salen de la potencia nominal de una ficha técnica ni de una hoja de cálculo. Salen de una cadena de medida real que termina en BullSens, nuestra plataforma IoT de monitorización de espacios y edificios:
Es el mismo criterio que defendemos en cualquier red de sensores: un dato solo es útil si se puede trazar hasta su origen. Y es también un buen ejemplo de cómo el IoT y la analítica de datos pueden integrarse en el propio proceso de medición. En el blog de BullSens puedes leer el ensayo desde el punto de vista de la monitorización energética.
Qué recomendamos según el caso de uso
Lo que este ensayo no responde
Un benchmark es útil en la medida en que se conocen sus límites. Los de este son claros:
Por eso, antes de llevar un modelo a producción, conviene validarlo con datos y tareas reales de la propia empresa y en el idioma en el que se va a utilizar.